Обучение VLA
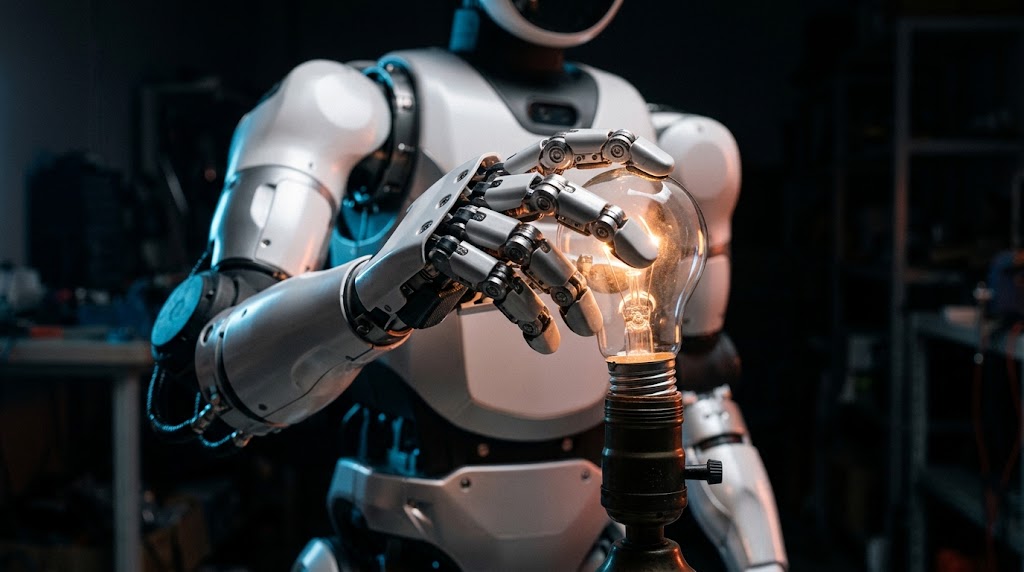
Обучение моделей «зрение-язык-действие» на демонстрациях телеуправления — например, G1 вкручивает лампочку.
- VLA
- Imitation Learning
- Manipulation
Обзор
Модели «зрение-язык-действие» (VLA) позволяют роботу получить изображение с камеры и инструкцию — «вкрути лампочку» — и сразу выдать действия.
Мы дообучили VLA на демонстрациях, собранных нашей системой телеуправления, и научили Unitree G1 с антропоморфной кистью выполнять точные манипуляции.
Задача
Чтобы вкрутить лампочку, нужны точное управление пальцами, постоянные мелкие поправки и понимание, когда лампочка встала на место.
Качество работы VLA сильно зависит от качества и единообразия демонстраций.
Наш подход
Собрали и отобрали набор демонстраций телеуправления с синхронизированными камерами и состояниями суставов.
Дообучили открытую VLA-модель на этих данных с аккуратной нарезкой действий и нормализацией.
Проверили на реальном роботе при разных положениях лампочки и освещении, возвращая неудачи в сбор данных.
Результаты
- Робот выполняет задачу с лампочкой из новых начальных положений (заглушка — добавьте процент успеха)
- Повторяемый цикл «данные → обучение → оценка» для новых задач манипуляции
Технологии
- Unitree G1
- Dexterous hand
- PyTorch
- LeRobot
- Hugging Face
- ROS 2